跳到主要内容

13 篇博文 含有标签「BK Lite」

查看所有标签

RAG 知识库越积越多,答案为什么越容易“打架”?

· 阅读需 8 分钟

晨会前的两个答案

晨会前二十分钟,运维负责人小周被问到一个很具体的问题:昨晚数据库连接数飙高,今天再出现同样的告警,值班应该先重启服务,还是先隔离流量?

团队的知识库里很快找到了两段回答。三年前的运行手册写着“重启后观察”;上个月的故障复盘却记录“这类现象先限制流量,直接重启会扩大影响”。

两份材料都不是胡写的。前者对应早期架构,后者来自后续依赖关系变化后的处置经验。可当它们被同一次检索一起召回时,小周拿到的不是答案,而是两个都像答案的选择。
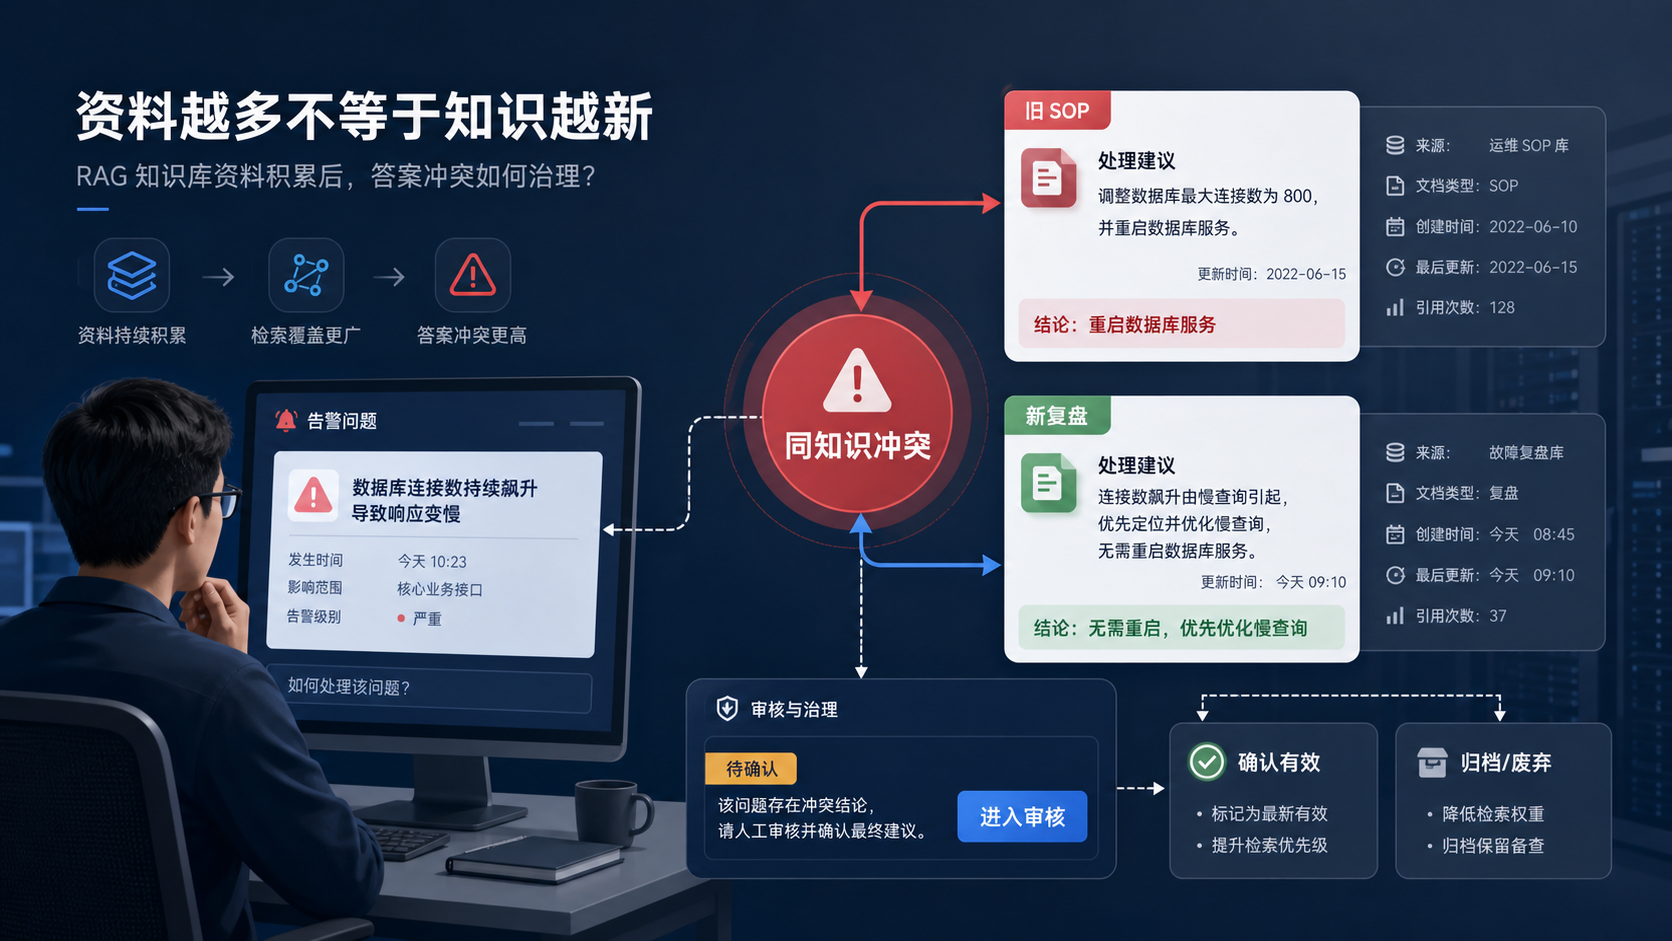
两份知识材料对同一告警给出冲突建议,等待进入审核治理

告警是自己恢复,还是被规则关掉?复盘时不能混成一种状态

· 阅读需 7 分钟

复盘从一句话卡住

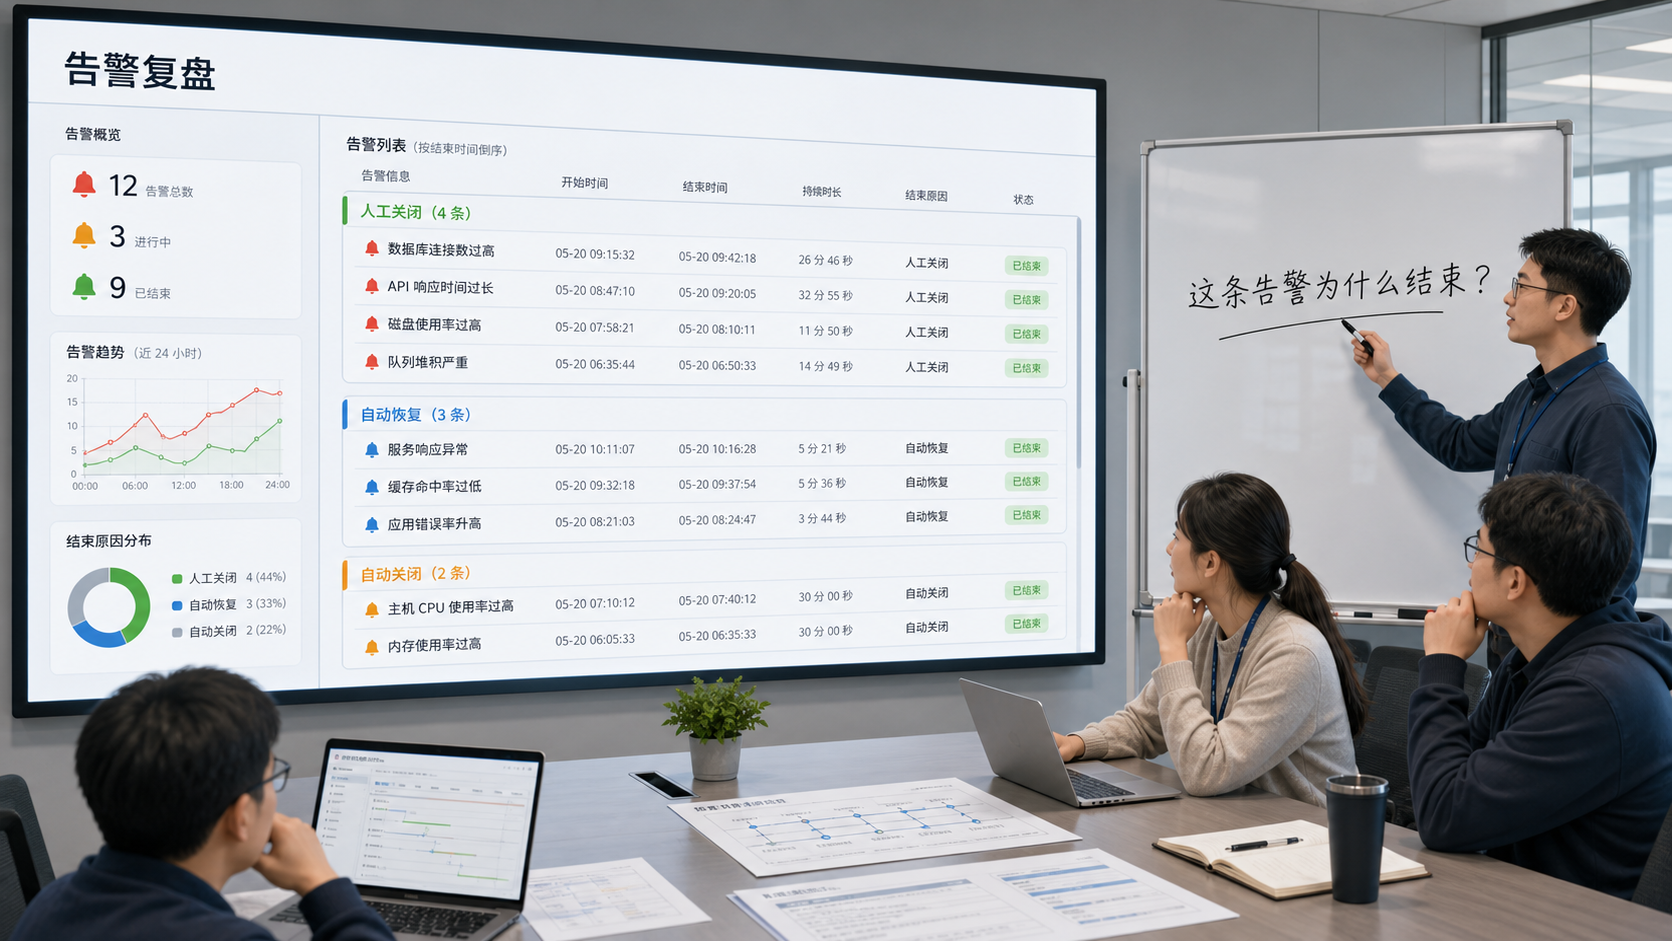
晨会前二十分钟,运维负责人小周被问到一个很具体的问题:昨天下午那批接口超时告警,到底是业务恢复了,还是规则自动关掉了?

他手里有告警列表,也有关闭率。列表上红点已经消失,几条告警都不再活跃。可继续往下追,现场开始卡住:有的告警是值班同学点了关闭,有的是恢复事件推回来的,还有几条是聚合告警过了不活跃时间后自动关闭的。

这时,“都结束了”反而变成最没有用的答案。

告警复盘真正要追的不是红点还在不在,而是它为什么离开了现场。

告警复盘现场中,团队正在区分人工关闭、自动恢复和自动关闭

等保要求下,密码策略如何守住身份入口

· 阅读需 8 分钟

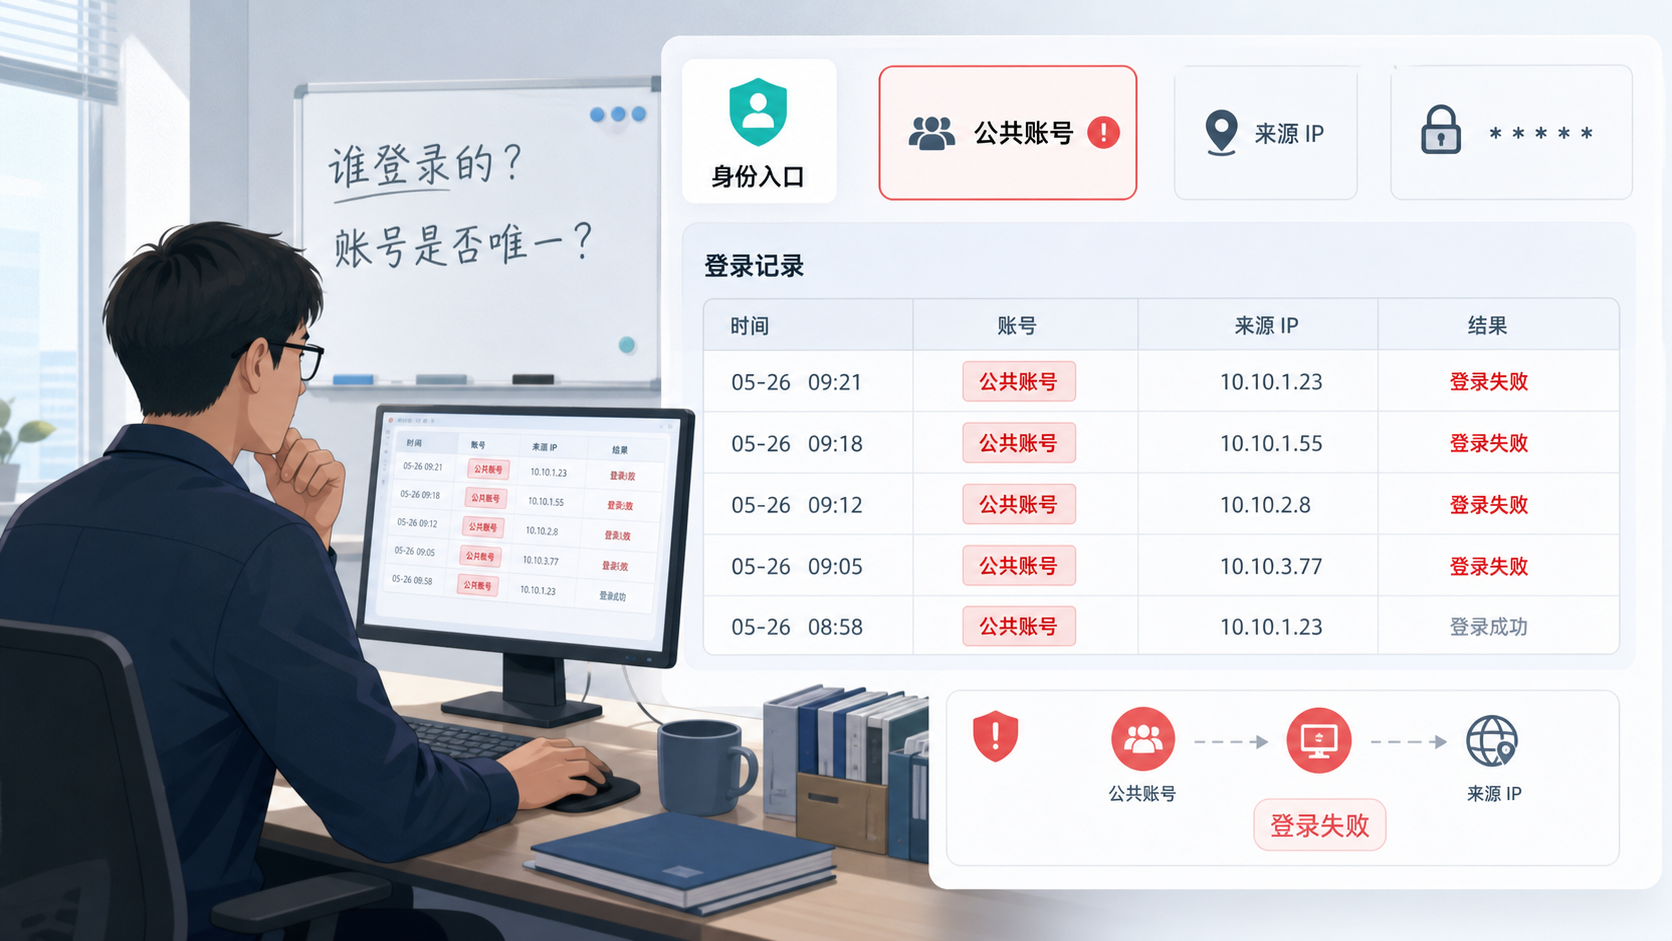
晨会前 20 分钟,运维负责人小李被问了一个很普通的问题:昨晚那次配置变更,到底是谁登录平台改的?

他打开审计记录,看到的是一个长期共用的运维账号。登录来源能查到,操作时间也能查到,但账号背后到底是哪位同事、哪家外包、哪次临时协助,没人敢马上下结论。

更麻烦的是,这个账号的密码已经很久没有换过。几个人都知道,浏览器里也可能保存过。复盘会还没开始,问题就已经从“谁改错了配置”,变成了“这个身份入口到底还能不能信”。

密码策略不是为了让登录页显得更安全,而是为了让账号、口令、会话和审计能连成一条可追溯的治理链。

共享账号和弱口令让身份入口失去追溯能力

K8s 集群 200 个 Pod,监控值班怎么「扫一眼」就定位异常

· 阅读需 7 分钟

一次上线后的故障响应

上线当天的上午 10 点 40 分,业务接口人在群里发了一条消息:“用户反馈响应慢,你们看看是不是后端出问题了。”

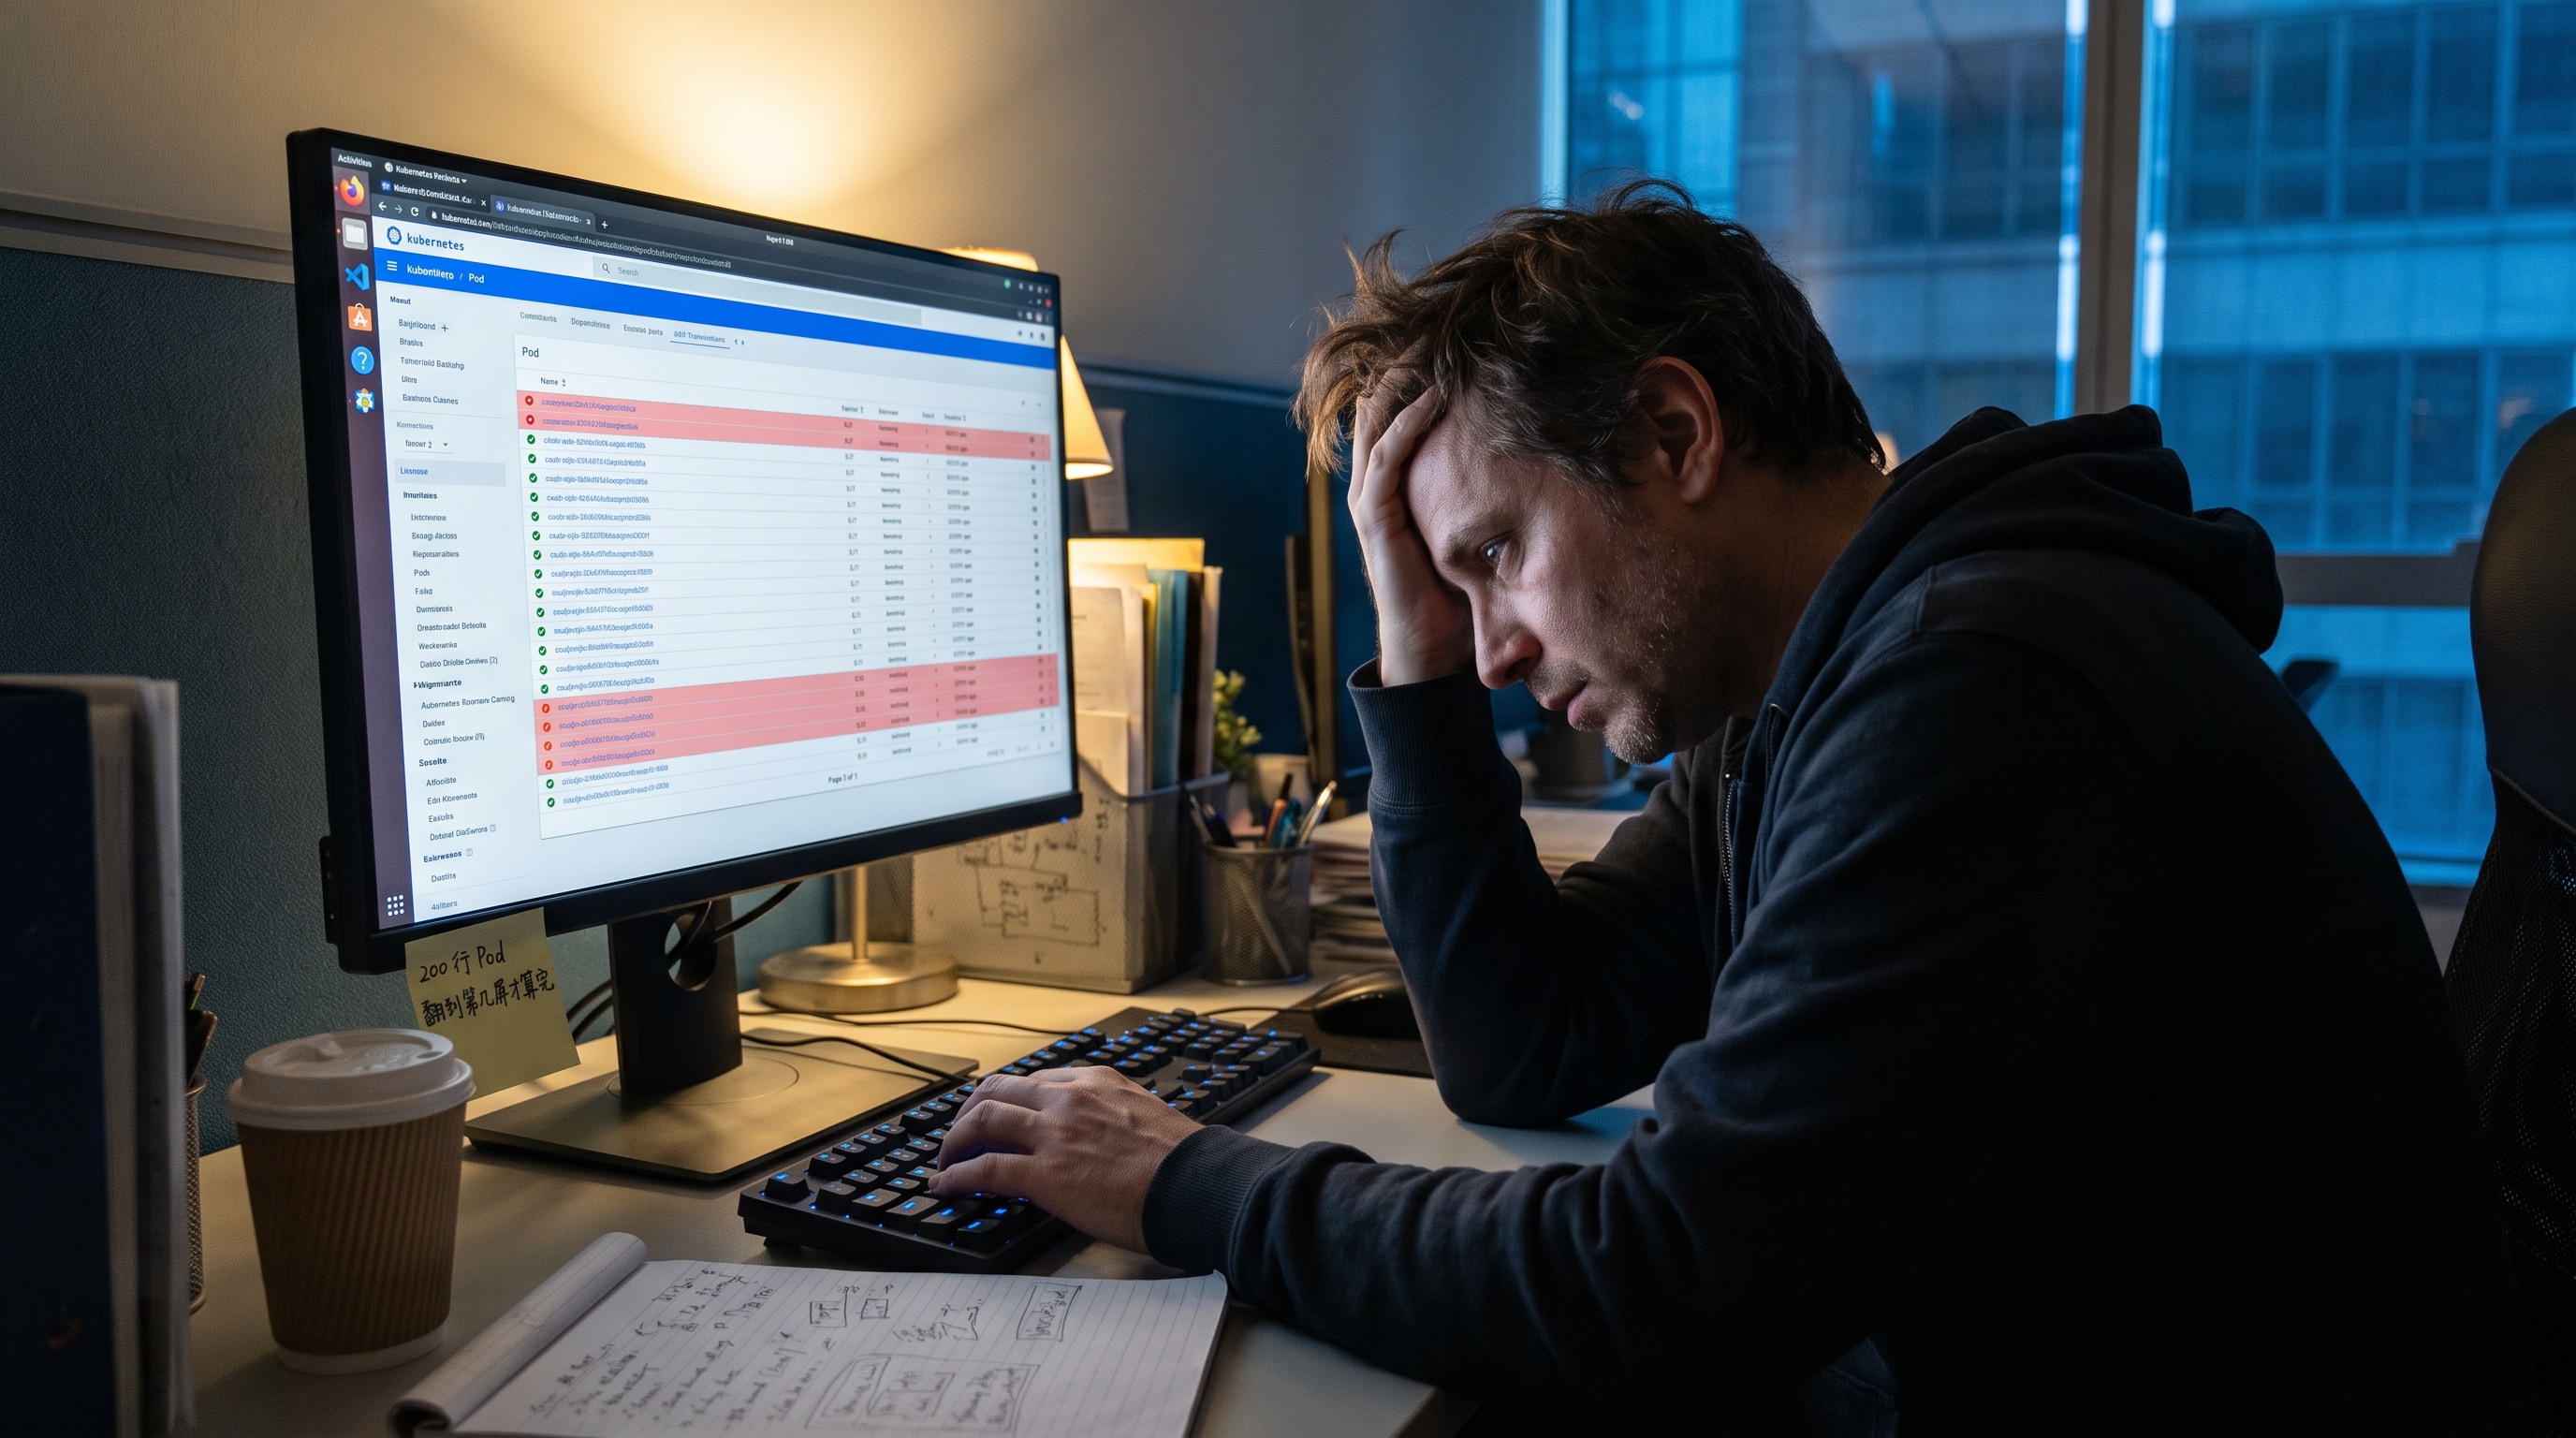
值班同学小周打开监控页面,看到的是 200 个 Pod 状态。

他想做的只有一件事:看哪几个不健康。

但这 200 行 Pod 状态,要滚 3 屏、4 屏、第 5 屏。他一直在做的不是排障,是“翻页找异常”。

群里开始有人追问“到底是哪个服务慢”。小周回到监控页,继续往下翻第 6 屏。

列表视图下 200 个 Pod 状态,值班翻屏找异常

翻到第 6 屏的时候,小周意识到,问题不是“列表不好用”,而是列表被错位用在了密度场景下

CMDB 5 万条资产只记得一个 IP,怎么跨模型找

· 阅读需 8 分钟

现场:小赵排障卡在 20 分钟,只因一个 IP

凌晨 1 点,小赵被叫起来处理一个 P2 告警。

告警说“10.0.1.5 节点上的服务响应超时”。他打开 CMDB,准备找一下这个 IP 是哪台机器、跑什么业务、归谁管。

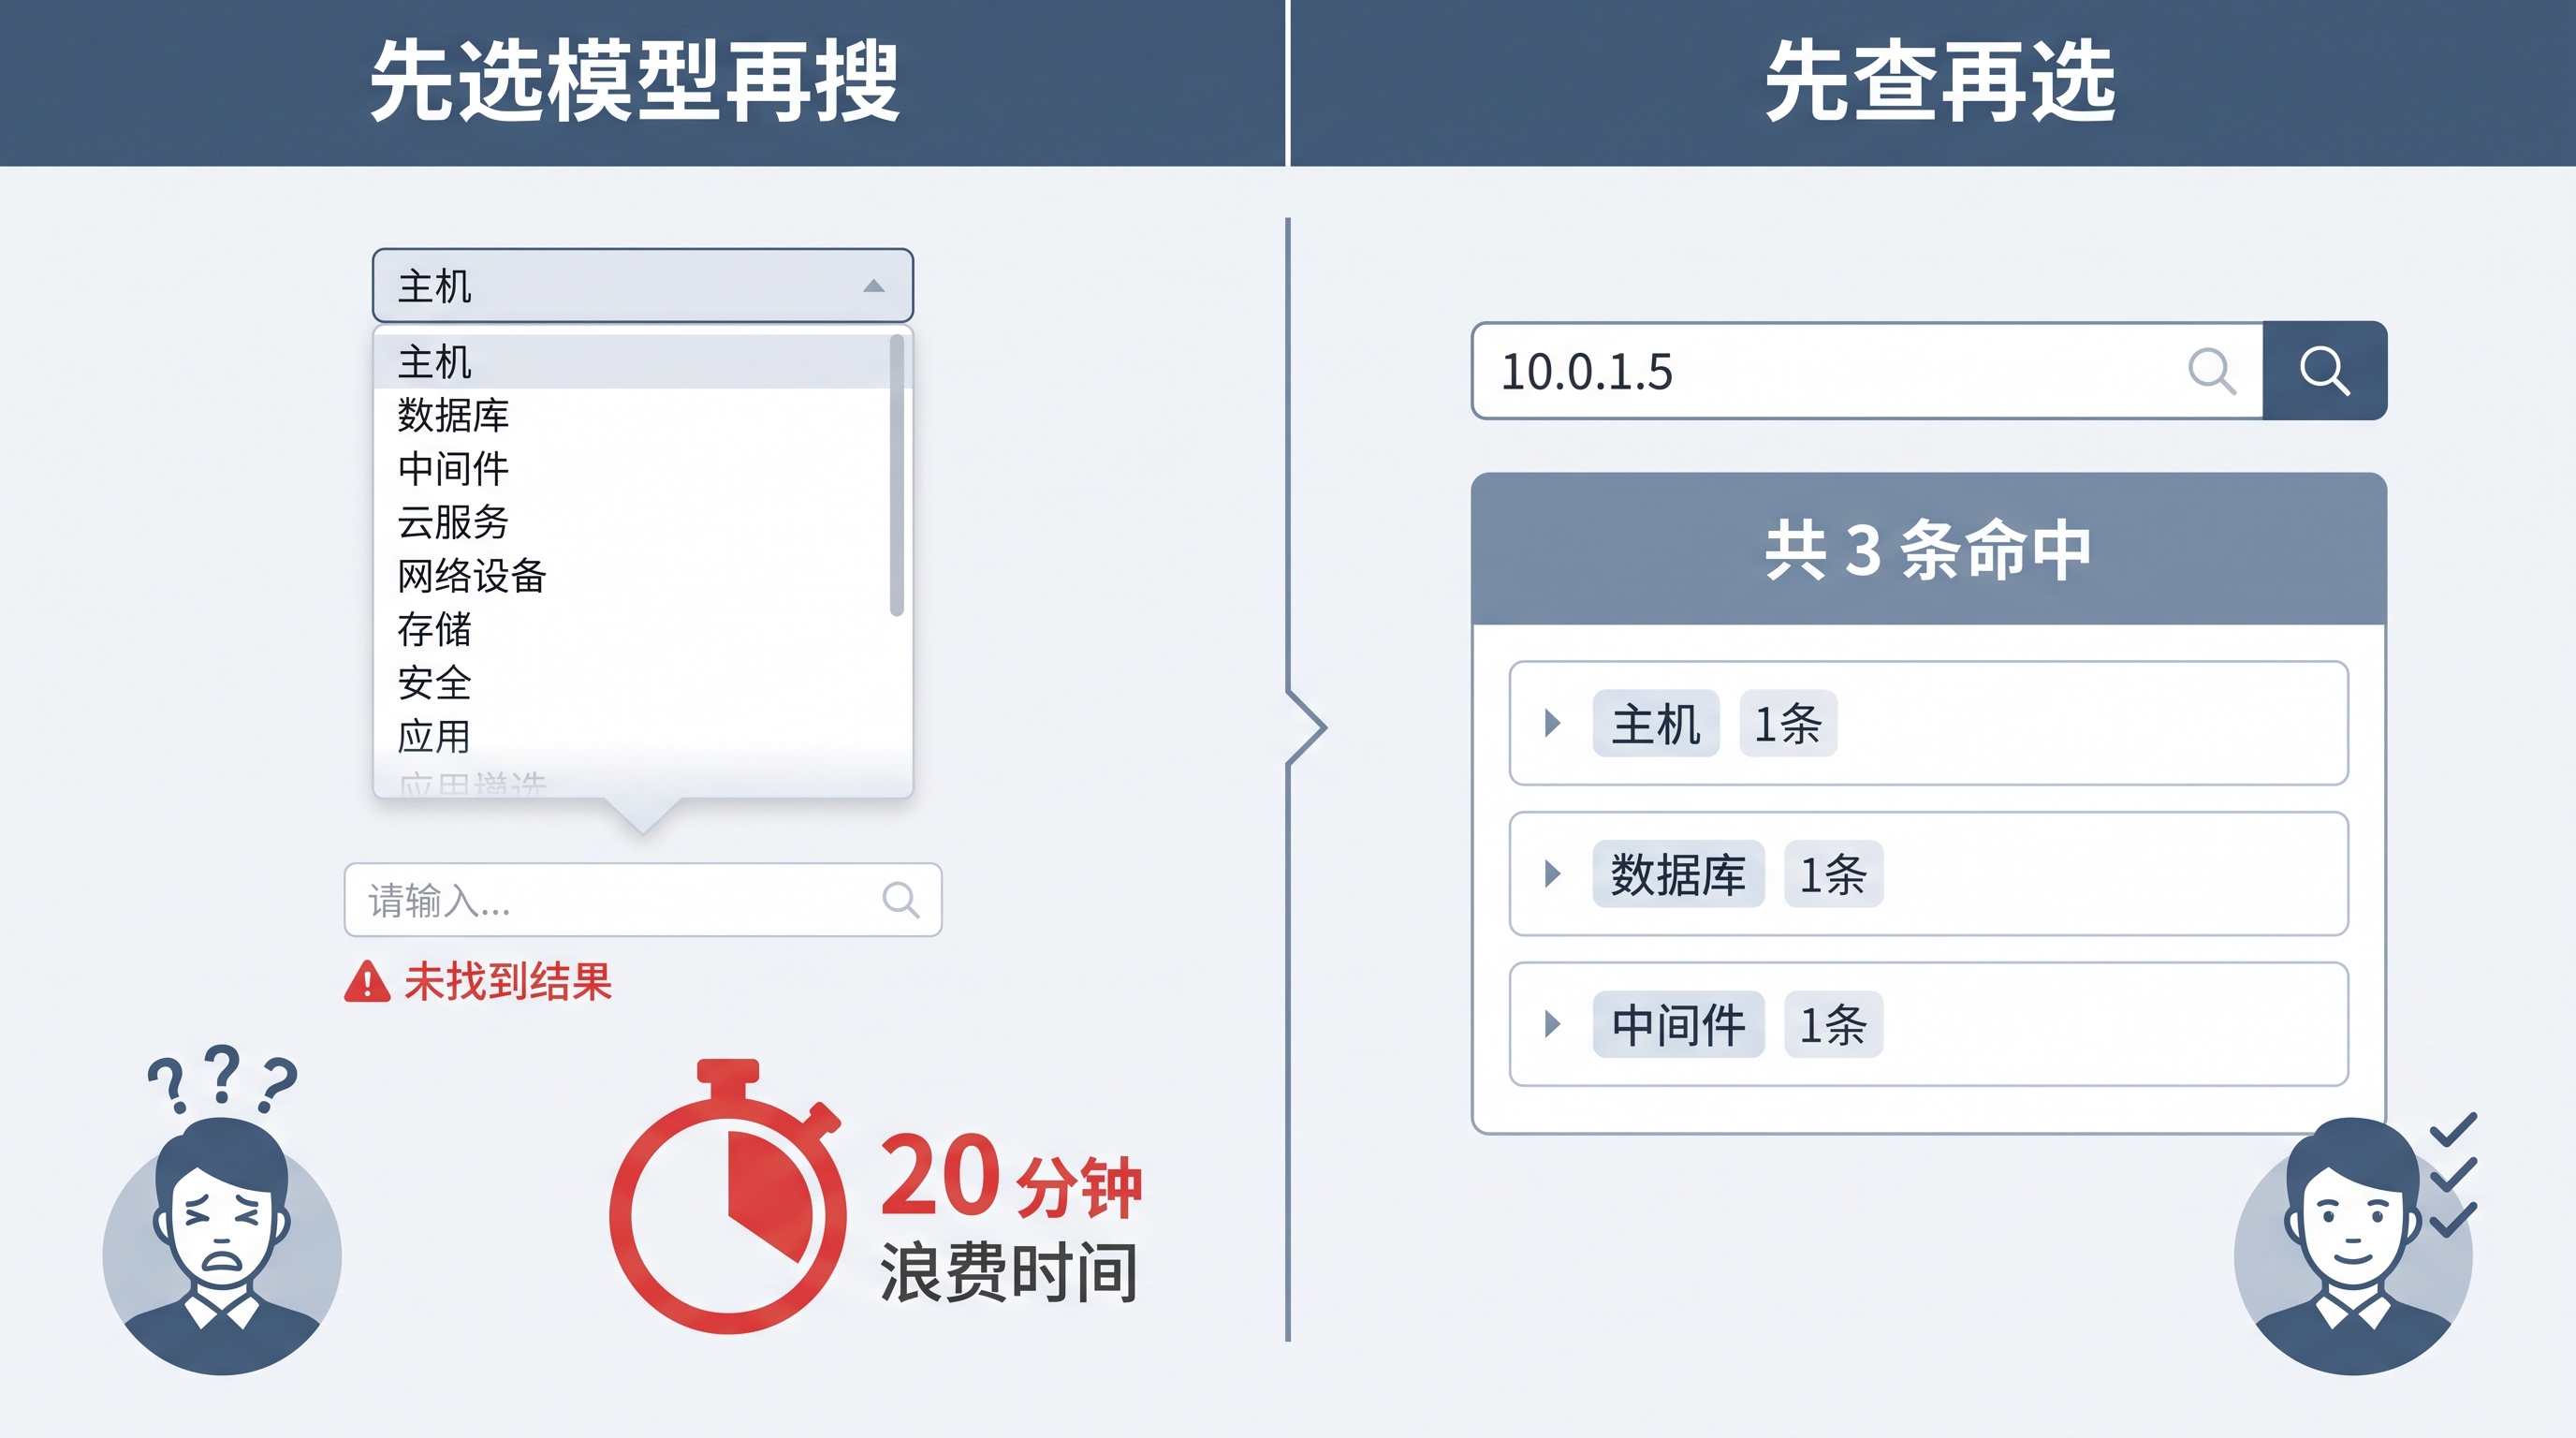
CMDB 里的资产有几万条。他凭直觉选了“主机”模型,在搜索框里输入 IP,没命中。

小赵在 CMDB 搜索界面反复切换模型

他改选“数据库”模型,搜索,还是没命中。

又改选“中间件”模型,这次命中了,但他心里没底:这个 IP 是不是同时也是某台主机?是不是同时也是某个数据库的部署目标?

他又回到“主机”模型,切换到精确匹配模式,再搜一次,这次命中了。

整个过程花了 20 分钟,中间切换了 3 个模型,还调整了一次匹配方式。

最后他发现,这个 IP 同时挂在 3 个模型下:主机模型 1 条、数据库模型 1 条、中间件模型 1 条。而他第一次搜的“主机”模型下其实是有命中的,只是因为大小写不敏感没匹配上

巡检脚本跑了 3 年没问题,作者一走就没人敢动

· 阅读需 9 分钟

现场:小周离职那天,运维组才意识到巡检脚本有多脆弱

周一上午 9 点,小周提交了离职流程的最后一项。

交接清单拉到第 17 行,写的是"日常巡检脚本 owner"。他手上有 6 份脚本,横跨 3 个业务线,跑得最久的一份已经稳定运行 3 年。每周值班同学都会在群里说"今晚脚本正常",从来没出过事。

交接会议上,接手的小李问了一句:"这份脚本,生产环境能改吗?"

小周想了想,说:"能改,但要按我之前发的那个流程。"

"流程在哪?"

"在我脑子里。"

小周离开后,运维团队围着黑屏讨论脚本交接

这不是个例。很多团队的巡检脚本,3 年的"稳态"其实是把 5 类信息全部装在作者脑子里。脚本本身只是冰山露出水面的那一角,水面下的"作者经验、运行历史、版本演进、参数命名习惯、依赖关系"才是真正在稳的部分。

作者一走,水面下这一整块就一起走了。脚本表面上没动,实际上已经失去了最关键的那一层支撑。

半夜里 P1 事故群里失控,事故到哪一步没人能答

· 阅读需 7 分钟

开场

凌晨 2 点,值班的小周刚看完一轮监控曲线,准备去倒杯水。运维群里弹出第一条 P1 告警——"支付回调链路数据库连接池告警"。他放下水杯,回了句"看到了",开始在群里同步。

5 分钟内,运维群、业务群、上游链路群同时炸开。告警截图、监控曲线、日志片段、临时方案、互相追问——所有信息都按时间顺序混在同一条消息流里。

20 分钟过去,群消息刷过 200 条。

业务方在群里 @ 小周:"事故处理到哪一步了?"

小周翻了一下聊天记录,迟疑了 5 秒。

没人能一句话答清楚。

凌晨 2 点值班现场:群里消息刷屏,值班同学看着屏幕

多环境脚本失控,往往从复制开始

· 阅读需 6 分钟

一次例行发布前,运维负责人小周收到了一项看似简单的任务:在测试、预发布和生产环境执行同一套服务检查。

共享目录里已经有三份脚本,文件名分别带着 testuatprod。但小周没有立即执行。测试脚本比生产脚本多了异常判断,生产脚本又多出一条临时诊断命令,预发布脚本里的接口地址还是旧值。

问题已经不再是“应该选哪个环境的文件”,而是没人能解释这些版本为什么不同。原本为了快速适配环境而复制的脚本,逐渐变成了三套各自演进的执行逻辑。

配置文件被改过没人知道,故障复盘就少了一段关键证据

· 阅读需 8 分钟

发布负责人小周是在复盘会上被问住的。

接口超时发生在发布后十几分钟。监控曲线有,错误日志也有,应用到数据库的依赖关系也能查到。所有材料看起来都在指向同一个方向:连接不稳定。

直到业务接口人问了一句:“故障发生前,连接池配置是不是刚调过?”

会议室安静了几秒。

有人翻发布记录,有人翻群消息,有人登录机器看当前文件。可当前文件只能证明“现在是什么样”,不能证明“当时是什么样”。真正卡住复盘的,不是没人看日志,而是没人能拿出配置文件在故障前后的版本和差异。

复盘最怕的不是线索少,而是线索到了配置层突然断掉。

故障复盘为什么总拼不出现场

· 阅读需 11 分钟

开场:晨会前那张拼不完整的图

晨会前 20 分钟,运维负责人小周被问住了。

昨天下午发布后,支付回调服务抖动了十几分钟。故障已经恢复,业务侧也确认交易补偿完成,但复盘材料迟迟拼不成一张完整图。

监控同学给了接口延迟曲线。

研发同学贴了几段带请求 ID 的错误日志。

CMDB 里能查到支付回调、缓存、数据库和下游账务服务的关系。

告警列表里也有触发、认领和恢复时间。

材料看起来很全。可复盘主持人追问了一句:

“这次到底是哪个点先异常?影响范围是一个实例、一条服务链,还是整段支付链路?”

会议室安静了几秒。

不是没人有数据,而是每个人手里都只有一块碎片。小周能解释其中任意一张截图,却很难把这些截图串成一个连续现场。

这就是很多故障复盘最难受的地方:证据都在,现场不在。