RAG 知识库越积越多,答案为什么越容易“打架”?
晨会前的两个答案
晨会前二十分钟,运维负责人小周被问到一个很具体的问题:昨晚数据库连接数飙高,今天再出现同样的告警,值班应该先重启服务,还是先隔离流量?
团队的知识库里很快找到了两段回答。三年前的运行手册写着“重启后观察”;上个月的故障复盘却记录“这类现象先限制流量,直接重启会扩大影响”。
两份材料都不是胡写的。前者对应早期架构,后者来自后续依赖关系变化后的处置经验。可当它们被同一次检索一起召回时,小周拿到的不是答案,而是两个都像答案的选择。
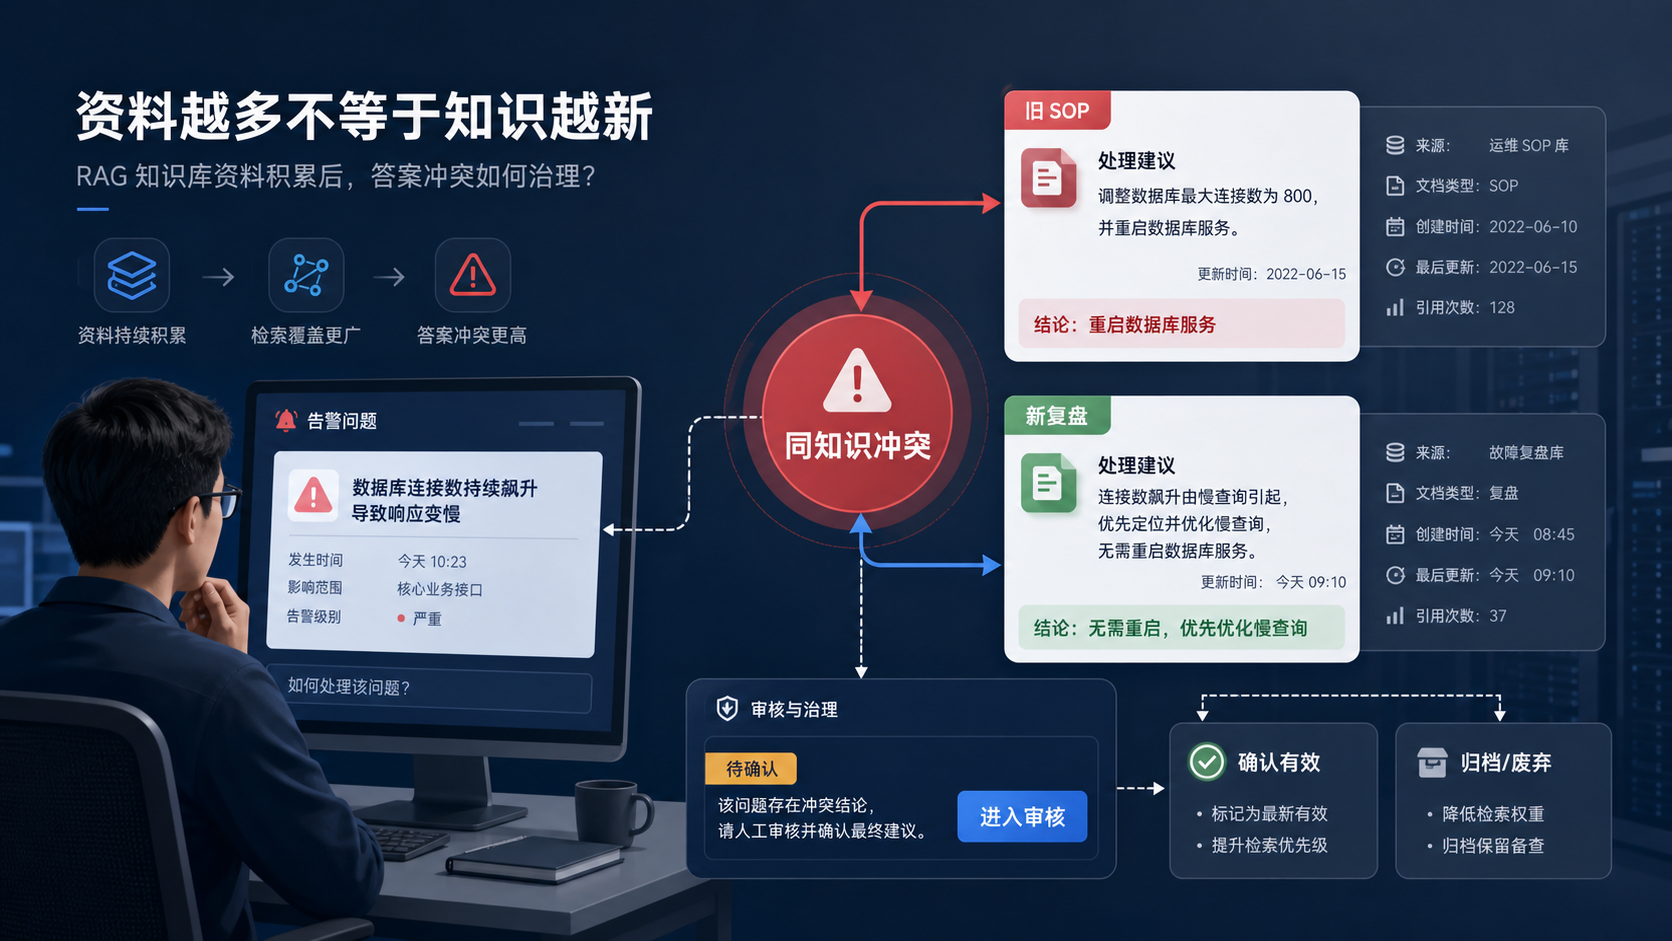
这就是许多 RAG 知识库进入长期使用阶段后最棘手的变化:资料没有丢,命中率可能还在提高,答案的可信度却开始下降。问题不一定出在模型胡编,而是知识之间失去了版本、范围与生效状态的秩序。
病根:相关不等于有效
RAG 的工作方式很清晰:先从知识库召回与问题相关的片段,再让模型基于这些片段组织回答。它擅长解决“散落的资料怎么被找到”,却不天然解决“找到的这段话现在该不该执行”。
一段旧 SOP 可能仍适用于某个存量环境;一份复盘结论可能只针对某次特殊事故;一页产品资料可能已经被后续版本替代。它们在语义上都与问题有关,却不该拥有同样的决策权重。
资料只增不减、相近主题只堆不管时,检索会把更多历史经验带到同一个上下文里。模型可以把文字拼得流畅,但它无法凭语义相似度替团队确认:哪个版本生效、哪个条件缺失、哪句话只应留作历史参考。
知识库真正失真的时刻,往往不是内容变错,而是曾经正确的内容离开了适用条件,仍被当作当前规范参与回答。
更新不能只靠重新入库
面对新资料,最常见的动作是上传、切分、入库,然后期待新的内容自然压过旧的内容。这个路径省事,却会在下一次追问时留下空白:答案为什么变了?改动来自哪份材料?原来的做法是否在某些场景里仍然有效?
把新内容直接覆盖当前页面,会把这些上下文一起抹平;把新旧文件全部留在检索范围内,又会让同一问题不断出现互相冲突的片段。二选一都不是长期维护的办法。
更稳妥的更新链路,应当让资料先成为可审阅的候选内容,再决定是否影响当前有效知识。以 OpsPilot 为例,资料会按队列构建为知识页面,并保留来源资料、构建时间和构建记录;资料更新可以生成多个候选版本,不会直接覆盖当前有效页面。
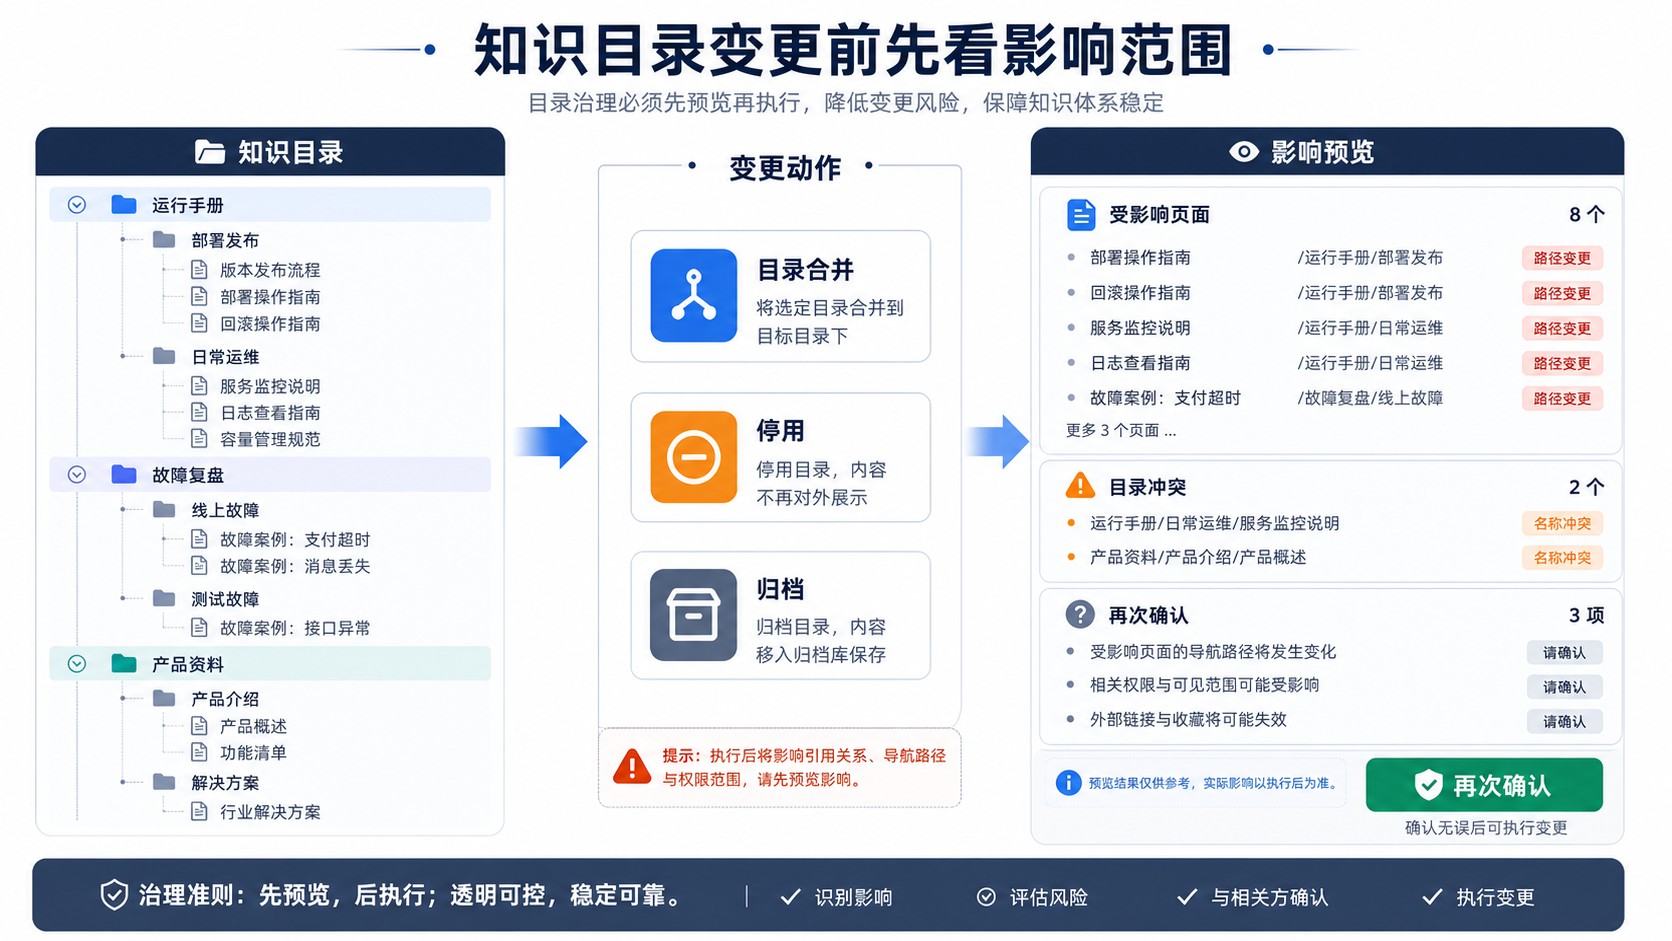
这段候选阶段不是多加一道审批,而是给团队留出判断空间。小周可以先把新复盘和旧 SOP 对照:如果复盘只针对一次特殊依赖故障,就把条件补回去;如果它确实推翻了旧步骤,再让新版本替换当前有效页面。这样,更新才是一条可回看的知识变更,而不是一次悄无声息的文件覆盖。
冲突要成为待确认项
小周接下来卡住的,不是“再搜一次能不能多找几篇文档”,而是这两段内容为什么会同时回答同一个问题。
这类情况需要被显式识别为“同知识冲突”:多份资料对同一知识给出不一致内容时,进入待确认,而不是继续藏在模型的召回上下文里。审核者需要回看来源、内容、适用范围和现行规范,再决定采用哪一项、合并内容,还是保留原有结论。
这里很容易把 LLM Wiki 想象成自动裁决真相的系统。更准确的定位是:它负责把资料中的矛盾识别并呈现为治理对象,最终哪一版生效仍由理解业务边界的人确认。未确认内容不应直接作为正式知识发布。
这也解释了为什么一味增加 Top K 或反复调整提示词无法根治问题。它们最多改变“哪些资料被拿来比较”,不能代替团队完成“这份资料是否应成为正式知识”的决策。
技术洞察:知识可信度取决于状态
RAG 知识库要长期可信,核心不只是文档质量,而是知识状态是否清楚。可以把一条知识的演进理解为下面四个状态:
- 来源可追溯:知道内容来自哪份资料、何时构建。
- 候选可比较:更新不会直接覆盖有效知识,而是先形成候选版本。
- 冲突可确认:不一致内容进入待确认,由人决定采用、合并或保留。
- 生效可说明:任何时刻都能回答当前被检索和使用的是哪一版。
如果这四层中缺一层,知识库就会回到“文件很多、结论靠猜”的状态。RAG 负责提高资料的可达性,治理链负责确保被找到的资料仍然值得使用;两者不是替代关系,而是同一套知识系统的两面。
目录是第二次失控点
内容确认之后,问题还没有结束。小周可能终于拿到了更新后的 SOP,却在目录里发现它仍被放在旧系统的运行手册下;另一份复盘被自动归到了无关分类,后来又被新同事当成通用方案引用。
因此,目录不是展示层的小事。人工移动过的页面应当保留人工归类;如果要恢复自动归类,也应该是一项明确的治理动作。对于目录合并、停用、归档等结构性变更,更应该先预览影响范围,确认受影响页面和冲突后再执行;结构或页面状态发生变化后,还需要重新预览再执行。
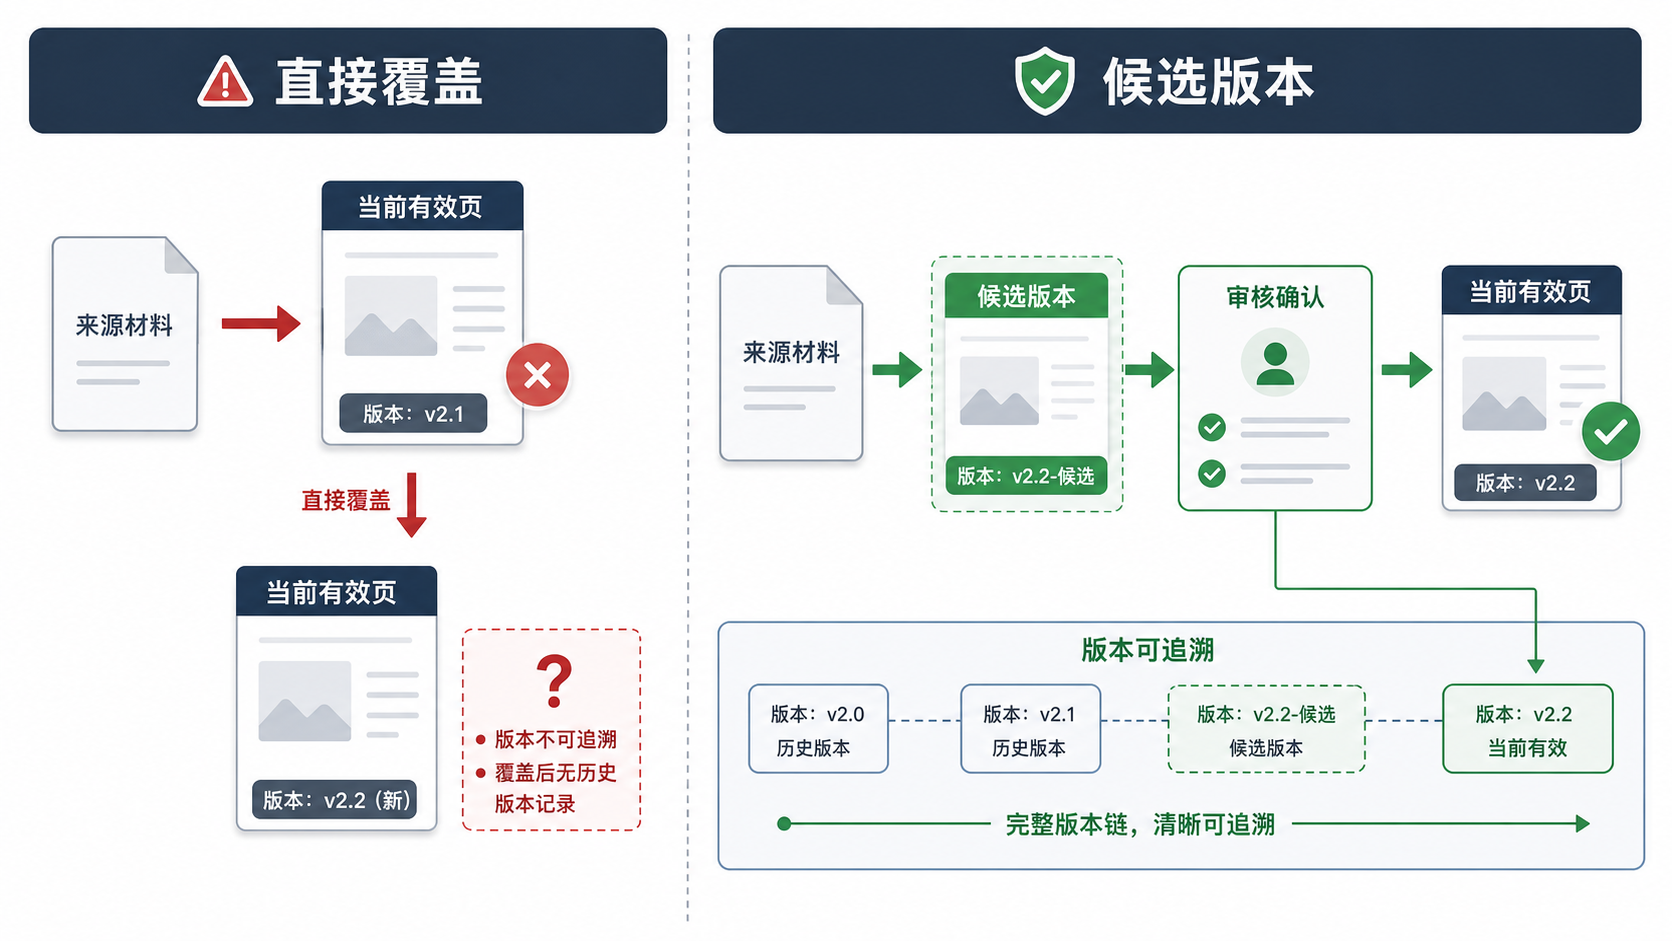
内容审核回答的是“这段知识能不能生效”,目录治理回答的是“它应该以什么入口被谁复用”。前者没有做完,答案会打架;后者没有做完,正确内容也会在错误的语境里被使用。
把一场故障串回治理链
回到晨会前的那个问题。理想的过程不应该是小周在两段文本之间凭经验下注,而应当是:他能先看到两份材料构成同知识冲突,核对新复盘是否覆盖了当前环境,再由对应负责人确认将它合并进正式 SOP 或保留为带条件的经验。
之后,新的有效页面有清楚的来源和版本状态;旧资料仍能被追溯,但不再与正式规范处于同一层级。若运行手册目录要调整,团队还能提前看到会影响哪些页面,而不是在整理完成后才发现入口被改乱了。
这条链把“回答一个问题”从模型的一次性输出,变成团队能够持续维护的知识资产。资料可以继续积累,历史也可以继续保留,但它们不必再一起争夺“当前答案”的位置。
上手前先问五句
在把长期资料接入 RAG 或 LLM Wiki 前,团队可以先做一次简单自查:
- 新资料进入知识库后,是否能追溯来源、构建记录和时间?
- 资料更新时,是否先形成候选版本,而非直接覆盖有效页面?
- 同一知识出现不一致结论时,是否有待确认和明确的审核决策?
- 目录合并、停用、归档前,是否先预览受影响页面与冲突?
- 基础模型发生变化后,是否重新训练资料并验证检索结果?
如果这些问题的答案还不够确定,优先要补的通常不是更多文件,而是知识的更新与确认机制。
结语
知识库的价值不在于记住得多,而在于需要行动时,团队知道该依据哪一版知识做决定。
RAG 可以让信息更快到达模型,LLM Wiki 则可以让冲突、候选、审核和目录影响进入日常治理。把这条链跑顺,资料的积累才不会随着时间变成互相打架的历史碎片,而会逐步沉淀为可追溯、可确认、能长期复用的团队知识。