服务没宕机,慢请求已经在吞掉用户耐心
发布完成后的第十分钟,支付确认页没有报错。
发布负责人小周盯着大盘:实例都在,接口成功返回,错误率也没有抬头。业务接口人却在群里转来客服消息:“页面一直转圈,用户点了两次还是没结果。”
小周先看了可用性,依然是绿的;再看平均时延,也没有离谱。要不要回滚?当下的证据还不足以支持这个动作。
但用户已经在等。这个现场最麻烦的地方就在于,表面上的“服务可用”与用户实际感受到的“操作顺畅”,并不是一件事。
病根:绿灯只回答了一个问题
可用性回答的是服务能不能访问。它能及时捕捉彻底中断,却不会自动说明每一次请求是否在用户可接受的时间内完成。
平均时延也会掩盖问题。假设九成请求依旧很快,只有少量请求被下游调用、排队或特定参数拖住,平均值可能还是平的。落在那一小段尾部请求里的用户,却会反复点击、刷新,最后离开页面。
服务在线只是可靠性判断的起点。对交互链路来说,尾部请求开始失速,就已经是需要正视的体验风险。
小周此刻缺的不是更多的总览图,而是一套能把“用户说慢”和“系统看着正常”接到一起的判断口径。
先把体验拆成可讨论的信号
把所有健康判断压成一盏绿灯,值班人员只能得到一个过于粗糙的答案。更实用的做法,是让每个信号回答自己的问题:
| 信号 | 它回答的问题 | 容易遗漏的风险 |
|---|---|---|
| 可用性 | 服务是否仍可访问 | 服务可用但响应变慢 |
| P95 / P99 | 多数与尾部请求是否仍在可接受时延内 | 平均值掩盖局部慢请求 |
| 错误率 | 失败是否正在增加 | 慢请求尚未转化为错误 |
| 吞吐 / 无流量 | 流量形态是否异常 | 入口、路由或链路出现变化 |
P95 更适合观察大多数请求的体验是否稳定,P99 则更容易让团队看见最慢那一小部分请求有没有持续恶化。它们不应被理解成又多了两条阈值,而是为“哪些用户正在被拖慢”提供共同语言。
阈值也不能脱离业务动作。支付确认、登录、搜索和后台批处理,对等待时间的预期并不相同。目标的作用不是把每次抖动升级成事故,而是把真正的例外一致地识别出来。
小周下一步该看哪里
当 P95 或 P99 开始失守,排障还不能停在“时延高了”。这个指标只说明问题值得追,不负责替团队判断根因。
小周需要把范围继续缩到具体服务、环境和端点:是所有路径都慢,还是发布后某个支付确认端点被拖住?再沿调用链看耗时集中在本服务处理,还是落在下游依赖。
这一步,错误率、吞吐和无流量也应作为相邻证据。错误率不涨,不等于体验没有风险;吞吐下降,也不一定意味着用户变少。不同信号拼起来,才有机会把“是否回滚”的判断从直觉推向证据。
技术洞察:目标与证据要接成一条线
- 目标告诉团队:体验是否已经偏离约定。
- 范围告诉团队:是哪项服务、环境或端点在偏离。
- 调用证据告诉团队:时间最终消耗在哪一段路径上。
如果只有目标,没有后续证据,团队会卡在“发现慢了”;如果只有调用链,没有体验目标,又很难判断哪些波动值得优先处置。
把几层重新串起来
回到小周的现场。可用性仍是绿的,并不能结束这次判断;它只说明没有发生完全中断。P95、P99 让他确认用户等待并不是偶然反馈,而是正在形成的尾部时延风险。
随后,服务、环境和端点让范围收窄;调用链继续把问题推向具体耗时路径。到这里,团队才有条件讨论应该优化、限流、调整依赖,还是回滚发布,而不是在“服务到底有没有问题”上反复拉扯。
可靠性的难点并不在于多看几张图,而在于让每一层观察都能把下一步行动指向更具体的证据。
用 APM 接住应用侧断点
在受信区域内网通过 OTLP 上报调用链的前提下,BK Lite APM 从应用侧提供服务、实例、RED 指标、端点、错误、调用链和服务拓扑等观察入口。
针对这类“服务还活着但请求变慢”的场景,它支持为指定服务及必选环境配置可用性、P95 时延、P99 时延三类 SLO。时延类目标需配置阈值,评估窗口可选滚动 7 天、滚动 30 天或自然月。这样,时延不再只是曲线上的一个尖峰,而可以进入服务目标是否达成的判断。
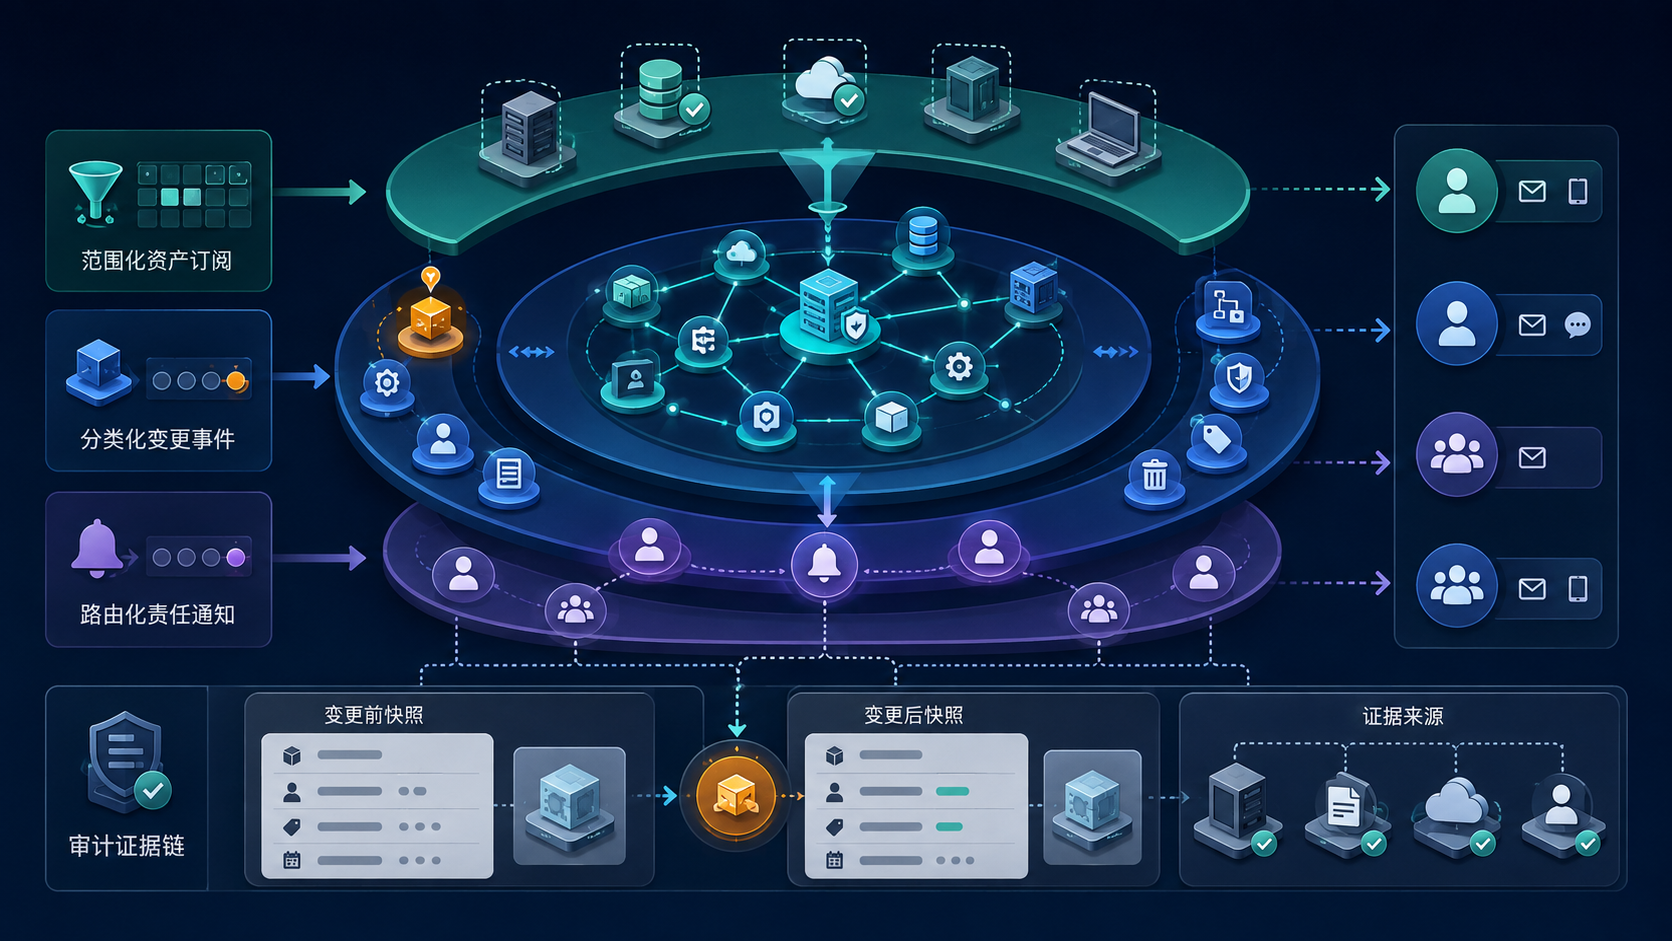
当需要通知时,APM 的自有告警限定为错误率、P95、P99、吞吐和无流量五种指标,且必须关联环境。它可投递通知,也可将事件副本单向抄送到告警中心;告警中心不会回写 APM 的告警历史。
调用链可按时间、服务、环境检索,窗口最长 35 天;服务拓扑的窗口最长 7 天。二者负责提供应用侧证据,但不替代资源监控或日志检索:资源指标仍应在监控系统中观察,日志内容仍应在日志系统中核对。
当前 BK Lite APM 是社区第一方 Beta 能力。它适合在符合现有试验边界的场景中验证服务目标、调用链与告警证据如何衔接;不应被描述为生产级 APM、自动根因定位或开箱即用的自愈能力。
上线后先问这几句
- 这条服务的可用性目标之外,是否也定义了与业务动作匹配的 P95 或 P99?
- 时延失守时,团队能否直接缩到服务、环境和端点,而不是从大盘重新猜?
- 调用链能否继续提供耗时分布的证据?
- 错误率、吞吐、无流量是否被当作不同方向的佐证,而不是一股脑塞进一个“健康”结论?
- 资源指标、日志和应用调用链的职责边界是否仍然清楚?
小周最后没有因为大盘是绿的就忽略客户反馈,也没有在证据不足时仓促定性。他先把尾部时延拉进服务目标,再沿调用链确认耗时分布。
服务没宕机,当然是好消息。但对用户而言,一次请求能否及时完成,才是更直接的可靠性体验。把目标、范围和证据接成一条线,绿灯之下的慢请求才不会总是等到投诉出现后才被看见。