定时任务运行异常,运维人员如何才能及时感知
晨会前二十分钟,运维负责人小杨收到业务接口人的消息:昨天的日报没有更新。
他先看监控。凌晨的日终同步没有错误数上升,主机 CPU 没有尖峰,告警列表也没有新记录。再打开任务执行记录,问题才露出来:这条本应在凌晨完成的同步,没有留下“同步完成”的那条事件。
现场最容易出现的误判是:没有报警,就先假定任务只是晚一点。
但报表已经停在昨天。对业务来说,任务是否抛出异常并不是最终答案;它有没有在约定时间交付应有的结果,才是。
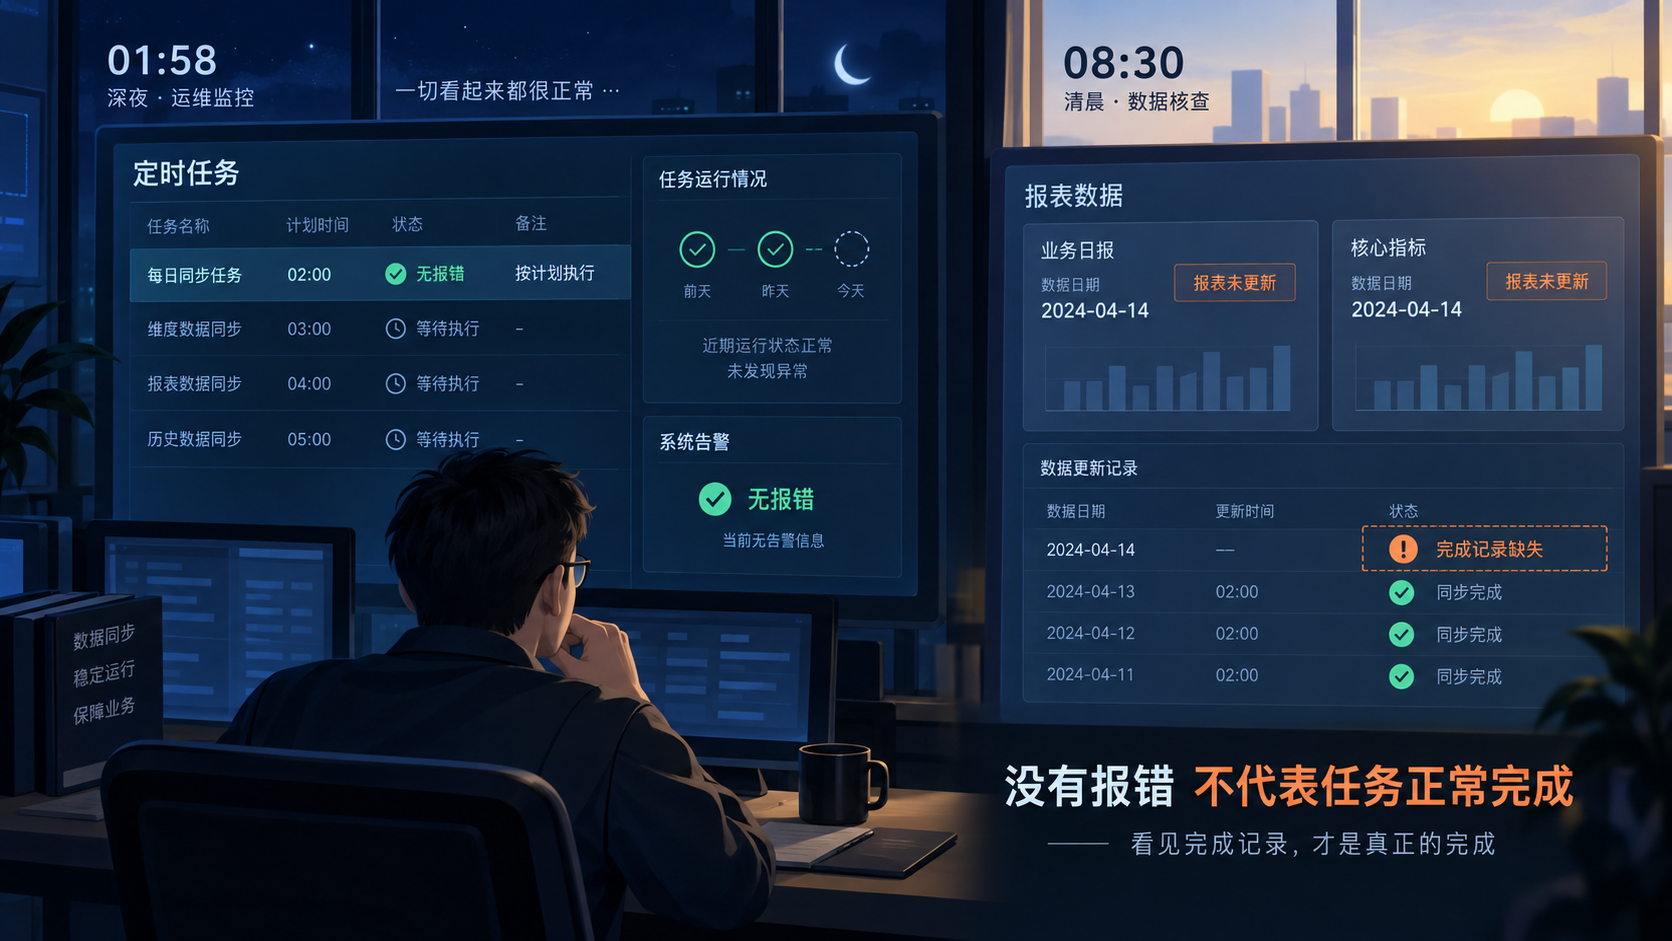
安静的值班台
小杨面对的不是一条典型的失败告警。传统监控擅长发现已经发生的异常:错误次数增加、耗时拉长、资源使用越界。这些判断都以系统先给出一条异常数据为前提。
而日终同步、每日汇总、巡检报告这类周期任务,常常会以另一种方式失效:调度没有拉起、依赖在中途卡住、结果没有投递出去。没有明确失败事件,监控自然也找不到可触发的异常值。
对周期任务而言,值班台的安静只能说明“还没看到异常值”,不能证明“任务已经完成”。
这也是为什么不少团队明明部署了监控,问题却仍然在第二天由业务侧发现。缺的不是一条更灵敏的阈值,而是一种针对“该来的结果没有来”的判断。
病根是观察对象错位
小杨继续往回查,发现此前的规则只关心两件事:任务有没有报错、机器有没有变忙。可业务真正依赖的是第三件事:同步完成记录有没有准时出现。
这三件事彼此有关,却不能互相代替。错误告警回答“系统是否暴露了失败”;指标告警回答“系统是否出现了性能异常”;缺失检测回答“约定要到达的事件是否在时间窗口内到达”。
把它们混在一起,最常见的后果是任务彻底停住时反而没有告警。因为没有错误,也没有指标波动,只有结果缺席。
一、先立住任务契约
要发现缺失,第一步不是配置告警,而是把“正常完成”说具体。
对小杨负责的日终同步来说,这份契约可以很简单:指定服务在每日处理结束后,产生一条“同步完成”事件;事件的来源、资源类型和资源标识能够把它与其他同步任务区分开;在规定的窗口内出现,才算本轮交付完成。
这一步看似基础,却决定后面的判断能不能成立。范围过宽,其他任务的完成事件会掩盖目标任务的缺失;范围过窄,发布后字段或标识变化又可能造成误报。
所以匹配条件要贴着任务的稳定边界设计,而不是用一句笼统的“收到同步事件”来代替。小杨需要先确认:到底是哪条任务、哪个来源、哪类资源在交付什么结果。
二、把时间窗口留给现实
契约明确后,第二个问题才出现:什么时候算它真的没来?
日终任务计划在凌晨运行,并不等于计划时刻一到就该报警。月末数据量增加、队列等待、上游响应变慢,都可能让一次正常执行比平时晚一些。
因此,缺失检测需要两层时间口径:用 Cron 定义检查节奏,再用宽限期容纳合理延迟。超过“预期检查点 + 宽限期”仍未匹配到完成事件,才把这次缺席视为需要介入的问题。
宽限期不是越长越稳妥。它太短,会把正常波动推给值班人员;它太长,任务停摆已经影响晨间报表,团队却还在等待。时间窗口应根据任务历史耗时、依赖链路和业务使用时间共同确定。
这时小杨才不必靠“感觉应该晚到了”做判断,而是有一个明确、可复核的检查窗口。
三、别让新规则先制造误报
规则刚创建时,平台可能还没有见过这类任务的正常完成事件。如果任务尚未投产、正处于计划停机,或者规则只是提前创建,立即按固定节奏检查就可能先报出一条没有意义的缺失告警。
缺失检测因此还要定义激活边界。对于已经稳定运行、交付节奏清晰的任务,规则保存后可以立即开始监控;对于刚接入或启停频繁的任务,更适合等首条符合条件的事件到达后,再进入正常观察。
这里补的不是功能细节,而是一层可信度控制:平台先确认这类事件确实在运行,再对它的后续缺席做判断。
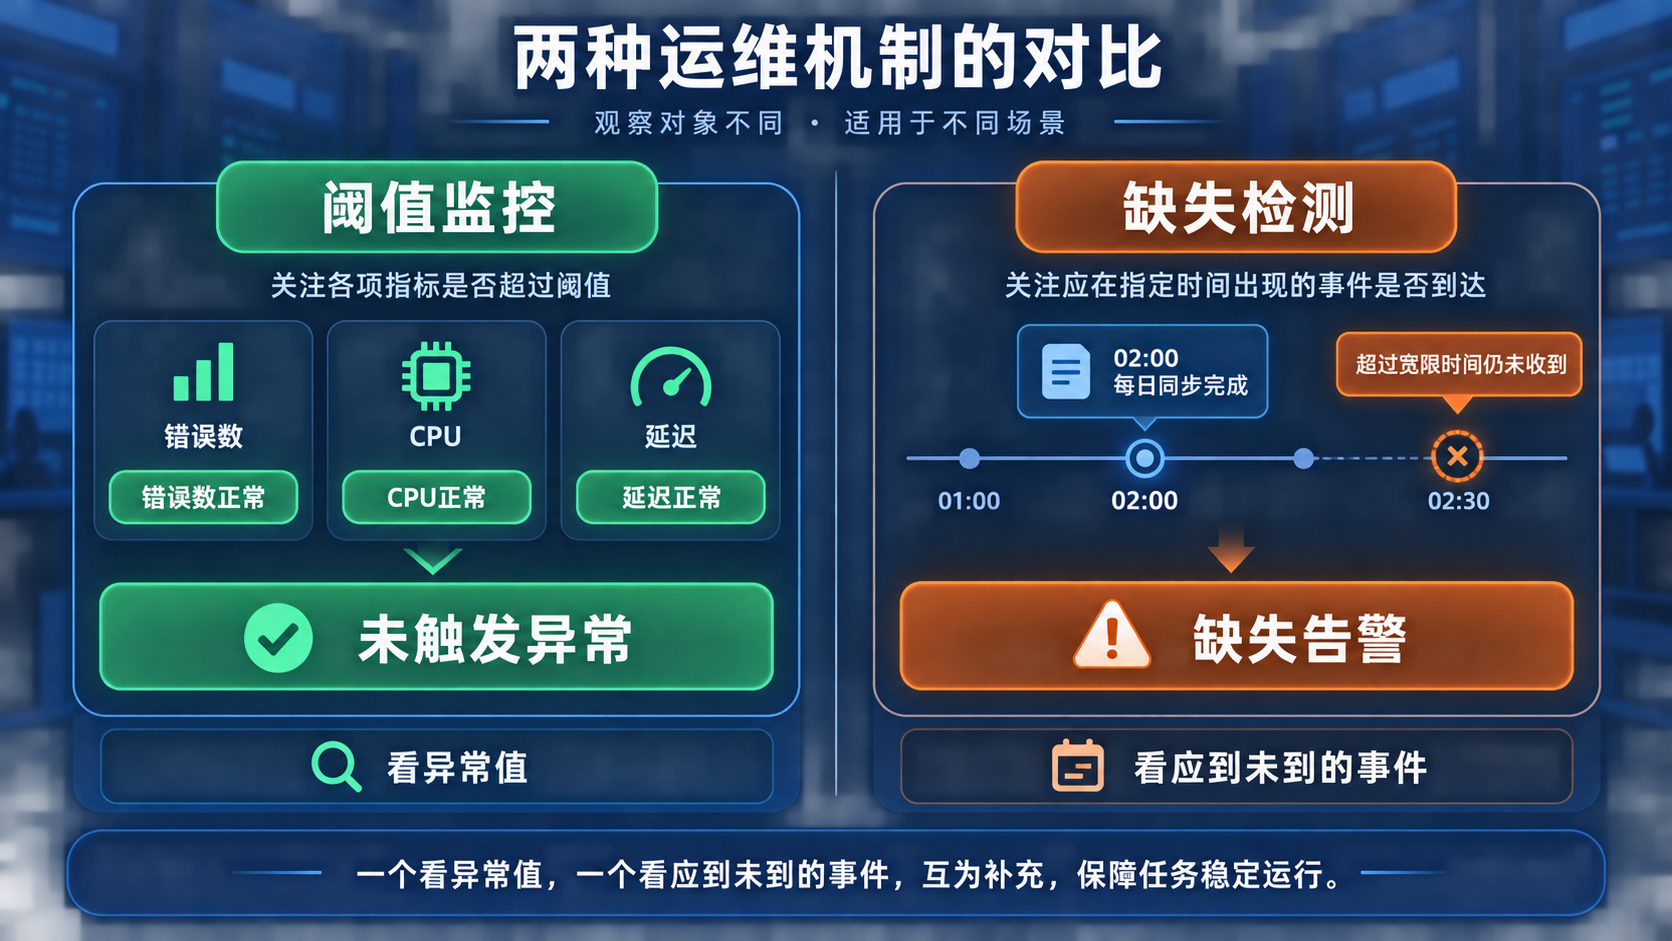
技术洞察:缺失不是“无数据”
缺失检测很容易被误解为泛化的无数据告警。两者的差别在于,前者并不是看到一段时间没有任何数据就下结论,而是围绕一条明确的任务契约做判断。
- 可识别:目标由服务、来源、资源等条件限定,不能把所有事件混在一起。
- 可预期:任务有清晰的检查时间和合理宽限期,而不是任意空窗都视为事故。
- 可恢复:后续一条符合条件的完成事件到达,能够证明链路重新回到正常观察。
小杨的日终同步之所以需要这套机制,正是因为它的风险不在“系统突然喊痛”,而在“业务等不到结果”。把事件、时间和范围绑在一起,缺失才从模糊直觉变成可执行的运维判断。
把告警收进闭环
检测到缺失只是开始。若规则在每次检查时都重新生成一条相同告警,值班人员很快会被重复通知淹没,也无法判断这到底是一场持续中的事故,还是多个独立故障。
更合理的状态流转是:规则先等待激活或进入监控;确认目标事件缺失后生成告警;在任务没有恢复前,不针对同一个缺口重复创建告警;后续再次收到一条匹配事件,告警自动恢复,规则回到监控状态。
这使告警拥有一个清晰的生命线:它从“缺失已确认”开始,到“完成事件重新出现”为止。小杨在告警详情里看到的,不再只是一个模糊的红点,而是一次可以继续跟进、可以验证恢复的任务中断。
用规则把判断落地
BK Lite 告警中心的关联规则提供了“缺失检测”策略,用来承接这段传统阈值监控覆盖不到的空白。
它要求先配置监听目标条件组,不能把所有事件无差别纳入。团队可以按服务、告警源、资源类型或资源标识圈定目标任务,再设置 Cron 检查周期和必填的宽限期,并选择立即激活或首条匹配事件到达后激活。
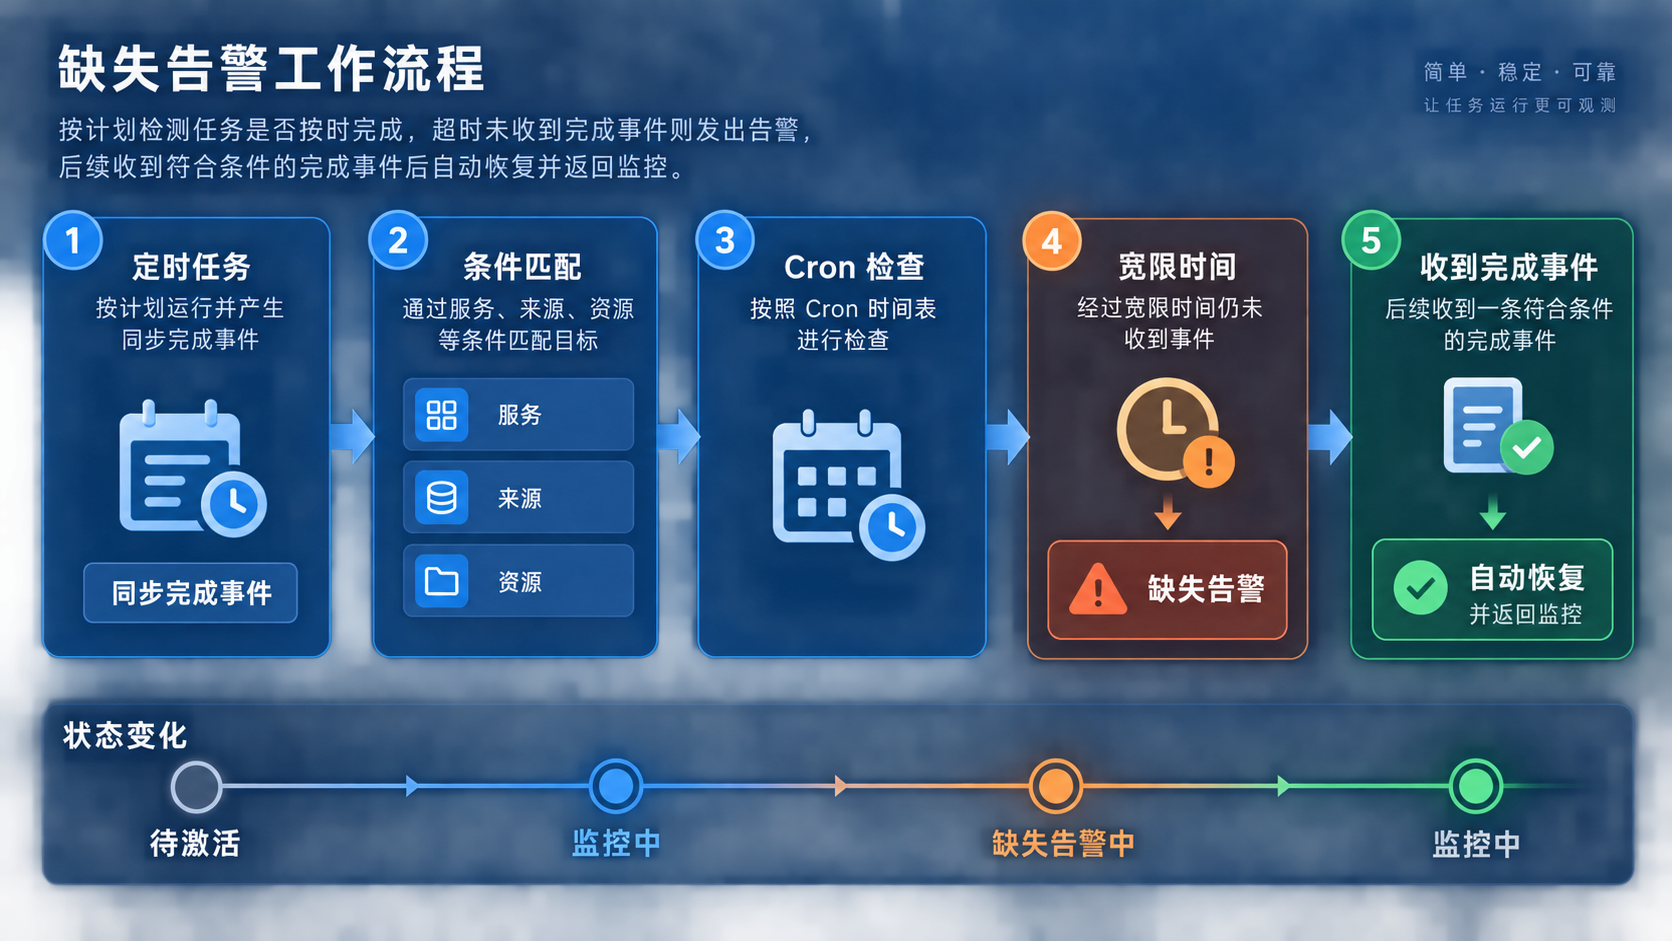
当超过预期时间与宽限期仍未收到匹配事件时,规则会按配置的名称、级别和摘要生成缺失告警。运行状态会区分待激活、监控中和缺失告警中,帮助运维人员判断规则是在等待首次有效事件,还是已经确认本轮任务存在缺口。
收到后续匹配事件后,告警自动恢复,规则返回监控状态。它不替任务补跑、不回填数据,也不能替代对业务数据完整性和根因的核验;这些仍需要由任务责任人沿着调度记录、执行日志和依赖链路继续处理。
BK Lite 在这里做的,是把“任务没有交付结果”及时变成一条可信、可处置、可恢复的告警,而不是等到业务侧发现报表缺页后再倒推。
上线前先问五句
准备为关键任务建立缺失检测前,可以先用下面五个问题做一次自查:
- 什么事件能证明这条任务已经完成,而不是仅仅开始执行?
- 哪些稳定字段可以准确圈定任务范围?
- 检查时间与业务使用时间是否对齐?
- 宽限期是否同时考虑了正常延迟与影响可接受时间?
- 告警出现后,谁负责排查、补跑和确认结果?
前四个问题决定告警是否可信,第五个问题决定它出现后能否真正缩短恢复时间。
让结果按时出现
回到晨会前那次排查,小杨最终需要处理的仍然是同步为什么没有完成。但缺失检测把发现时点从“业务打开报表之后”,提前到了“完成事件没有按时到达之后”。
这段提前量不只是少一条工单。它让运维在业务后果扩散前就拥有一个明确入口:哪条任务没有交付、从什么时间开始缺失、恢复事件有没有回来。
对定时任务而言,可靠性不仅是失败时能够报警,更是到了该交付结果的时刻,能够确认结果确实出现。